Métodos para nomear, medir e demonstrar lacunas científicas com rigor
Aldemar Araujo Castro
Criação: 29/10/2026
Atualização: 29/10/2026
Palavras: 4200
Tempo de leitura: 21 minutos
Mapa sobre a mesa
o lápis hesita à margem
da terra sem nome
Resumo. Este texto examina como identificar, classificar e justificar uma lacuna de pesquisa com rigor metodológico, em vez de apenas declará-la. Parte da distinção entre ausência de estudos e insuficiência de evidência e percorre cinco famílias de métodos: taxonomias conceituais, ferramentas de avaliação da evidência, acrônimos de decomposição da pergunta, métodos participativos de priorização e técnicas computacionais de leitura da literatura. Discute ainda o papel da inteligência artificial generativa, com suas utilidades e seus limites, e propõe um roteiro integrado. O leitor encontrará critérios práticos para redigir justificativas que resistam à banca e ao parecerista.
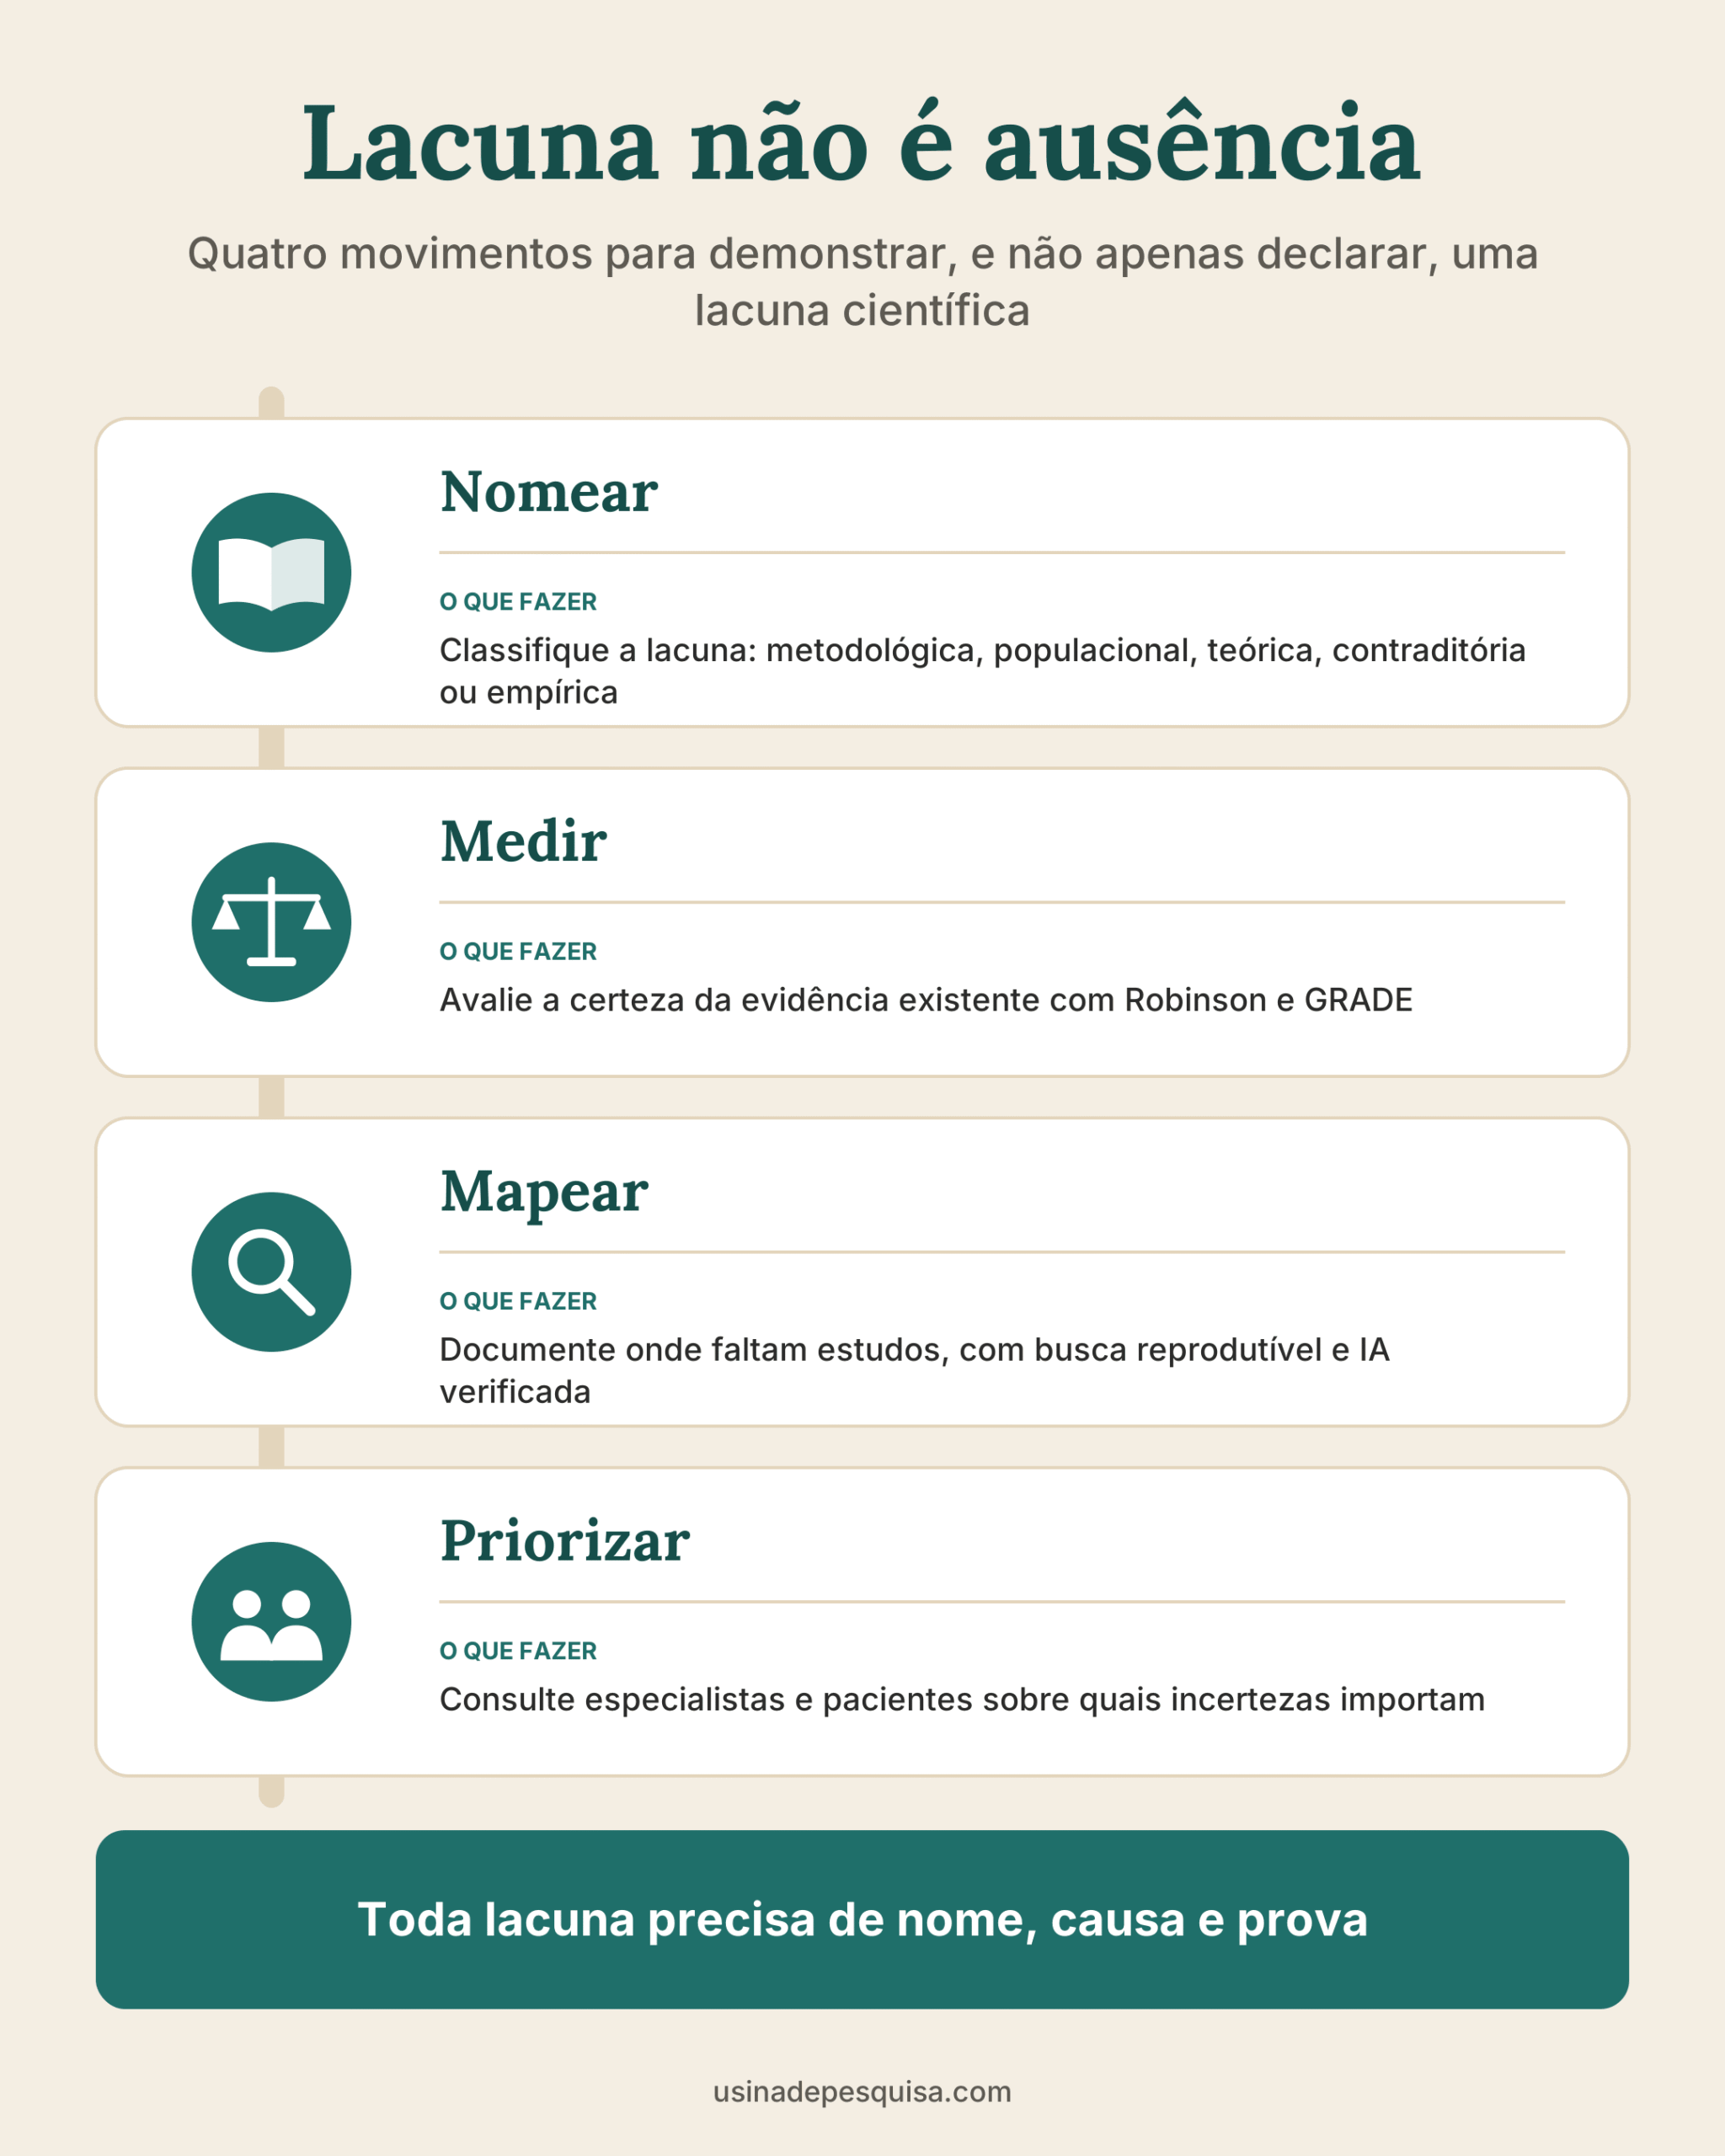
Quatro movimentos transformam a lacuna de declaração em demonstração.
Introdução
A cena se repete nas bancas de qualificação e nos pareceres de periódicos. O pós-graduando apresenta o projeto, chega à justificativa e afirma com convicção que não há nada publicado sobre o tema. O avaliador faz uma única pergunta: onde você procurou? A resposta costuma revelar duas bases consultadas, uma combinação improvisada de palavras-chave e nenhum registro da busca. O argumento que parecia o mais forte do projeto desmorona em segundos.
O problema não está na intenção, mas no estatuto lógico da afirmação. Dizer que algo não existe é fazer uma afirmação empírica, e afirmações empíricas exigem método. Há ainda um equívoco mais sutil: a ausência de artigos raramente é a verdadeira lacuna. Com frequência há estudos, mas eles são pequenos, enviesados, contraditórios ou feitos em populações diferentes daquela que interessa ao pesquisador. Confundir ausência com insuficiência de evidência é o erro de origem de muitas justificativas frágeis.
Este texto apresenta as ferramentas que a literatura metodológica oferece para transformar a lacuna de declaração em demonstração. Elas se distribuem em cinco famílias: taxonomias que dão nome à lacuna, instrumentos que medem a fragilidade da evidência, acrônimos que decompõem a pergunta, métodos participativos que priorizam incertezas e técnicas computacionais que leem a literatura em escala. Ao final, discute-se o lugar da inteligência artificial generativa nesse processo e propõe-se um roteiro para combinar os métodos ao longo do projeto.
O falso argumento do “nada publicado”
Uma lacuna de pesquisa não é um espaço vazio na estante da biblioteca. Na formulação de Robinson e colaboradores, ela corresponde a um tema ou área em que informação ausente ou inadequada limita a capacidade de chegar a uma conclusão sobre determinada pergunta (Robinson et al., 2011). A definição desloca o foco: o que importa não é quantos artigos existem, mas se o conjunto disponível permite responder à pergunta com segurança. Dez estudos pequenos e discordantes podem configurar uma lacuna mais séria do que a ausência completa de publicações sobre um tema irrelevante.
Essa constatação tem consequência prática imediata. Ao revisar o que faziam as organizações dedicadas à síntese de evidências, Robinson e colaboradores observaram que relatórios de revisões sistemáticas costumavam trazer recomendações de pesquisa futura, mas quase nunca explicavam como as lacunas tinham sido identificadas, e apenas uma minoria das organizações utilizava algum framework explícito para isso (Robinson et al., 2011). Se até as instituições especializadas tratavam a lacuna de modo intuitivo, não surpreende que o pesquisador iniciante faça o mesmo.
A heterogeneidade conceitual também é documentada. Uma revisão de escopo que reuniu 139 publicações sobre métodos para identificar, priorizar e exibir lacunas em pesquisa em saúde encontrou grande variedade de definições e procedimentos, que iam da síntese de conhecimento ao inquérito com especialistas, passando por estudos bibliométricos e exercícios formais de priorização (Nyanchoka et al., 2019). Não há, portanto, um método único e consagrado. Há um repertório, e cabe ao pesquisador escolher e declarar o que utilizou.
Convém ainda distinguir três noções que a linguagem cotidiana costuma fundir. A lacuna é a constatação de que a evidência é insuficiente. A necessidade de pesquisa é a tradução dessa lacuna em um estudo concreto, com população, desenho e desfecho definidos. A prioridade é o juízo sobre quais necessidades devem ser atendidas primeiro, considerando relevância, viabilidade e interesse de quem usa os resultados. Uma justificativa robusta percorre os três níveis, e cada família de métodos apresentada a seguir contribui para um ou mais deles.
Dar nome à lacuna: as taxonomias
O primeiro passo para demonstrar uma lacuna é nomeá-la com precisão. Nomear significa classificar: dizer se o problema é de conhecimento inexistente, de resultados contraditórios, de método inadequado ou de população negligenciada. A vantagem é dupla. O avaliador compreende de imediato qual barreira o estudo pretende superar, e o próprio pesquisador é obrigado a sair da generalidade.
Uma das propostas mais citadas é o framework apresentado por Müller-Bloch e Kranz em 2015, nos anais da International Conference on Information Systems. Os autores analisaram quarenta revisões de literatura com abordagem de teoria fundamentada nos dados e derivaram seis tipos de lacuna. A lacuna de evidência contraditória surge quando estudos sobre o mesmo fenômeno chegam a conclusões divergentes. O vazio de conhecimento corresponde à ausência de investigação sobre determinado aspecto. O conflito entre ação e conhecimento aparece quando a prática profissional se afasta do que a pesquisa recomenda, ou quando a pesquisa ignora o que a prática já faz. A lacuna metodológica decorre de desenhos que limitam a validade dos achados. O vazio de avaliação indica que intervenções ou teorias existentes nunca foram testadas empiricamente. O vazio de aplicação teórica sinaliza que uma teoria potencialmente útil ainda não foi empregada naquele domínio.
Em 2017, Miles reorganizou essas categorias em uma taxonomia de sete tipos, apresentada em um workshop para doutorandos realizado em Dallas, nos Estados Unidos: lacuna de evidência, de conhecimento, de conflito entre conhecimento e prática, metodológica, empírica, teórica e populacional. Esta última merece atenção especial nas ciências da saúde, porque designa populações sub-representadas na pesquisa, como idosos frágeis, gestantes, povos indígenas ou pacientes atendidos fora dos grandes centros. Um esclarecimento é necessário: o trabalho de Miles não foi publicado em periódico com revisão por pares, embora circule amplamente e seja muito citado. Pode ser usado como vocabulário de trabalho, mas não deve ser apresentado como padrão internacional consolidado.
Alguns textos atribuem a Jacobs, em 2011, uma tipologia anterior com dimensões de generalização, aplicação e evidência contraditória. A referência aparece em trabalhos posteriores, inclusive no de Miles, mas não foi possível localizar a fonte primária para conferir seu conteúdo, razão pela qual ela é mencionada aqui apenas como antecedente histórico.
Na prática, as taxonomias servem para redigir a frase central da justificativa com precisão. Em vez de “pouco se sabe sobre o tema”, o pesquisador escreve que os estudos existentes apresentam resultados contraditórios quanto ao desfecho principal, ou que nenhum deles incluiu pacientes acompanhados na atenção primária. Uma mesma pergunta pode reunir mais de um tipo de lacuna, e reconhecer essa sobreposição costuma fortalecer o argumento.
Preencher ou problematizar
Nomear a lacuna resolve o problema da precisão, mas não o da relevância. Sandberg e Alvesson analisaram 52 artigos de estudos organizacionais para entender como os pesquisadores constroem suas perguntas a partir da literatura e constataram o predomínio do que chamaram de gap-spotting, isto é, a busca por lacunas a preencher (Sandberg e Alvesson, 2011). Identificaram três modos principais. O confusion spotting parte de evidências conflitantes e propõe esclarecê-las. O neglect spotting aponta áreas negligenciadas, pouco estudadas ou carentes de apoio empírico. O application spotting estende uma teoria ou um modelo conhecido a um contexto em que ainda não foi aplicado.
O diagnóstico dos autores é provocativo. O gap-spotting não é ilegítimo, mas tende a reforçar as teorias existentes em vez de questioná-las, porque aceita os pressupostos da literatura e se limita a acrescentar peças ao quadro (Sandberg e Alvesson, 2011). O resultado é uma produção incremental, útil para acumular dados, mas raramente capaz de mudar a forma como um campo pensa. Os autores atribuem essa preferência a normas sociais da carreira acadêmica: a pressão por publicar, a expectativa dos periódicos e a segurança de dialogar com o que já está estabelecido.
Como alternativa, Alvesson e Sandberg propuseram, em trabalho complementar publicado no mesmo ano, a problematização: identificar os pressupostos que sustentam uma linha de pesquisa, articulá-los explicitamente e avaliar se resistem ao escrutínio. Os pressupostos podem ser internos a uma escola de pensamento, metáforas de base, premissas de paradigma, compromissos ideológicos ou consensos de todo um campo. A pergunta que nasce da problematização não é o que ainda falta saber, mas o que a literatura dá como certo e talvez não devesse.
Um exemplo hipotético ajuda a perceber a diferença. Uma linha de pesquisa sobre adesão ao tratamento pode tratar a não adesão como atributo do paciente, a ser corrigido por educação em saúde. O gap-spotting proporia testar a mesma intervenção educativa em outra população. A problematização perguntaria se o pressuposto está correto, e se a não adesão não decorre, ao menos em parte, da organização do serviço, do custo do transporte ou da forma como o tratamento foi prescrito. A segunda pergunta é mais arriscada e mais difícil de financiar, mas tem maior potencial de mudar a prática.
Para a maioria dos projetos de graduação e mestrado, o gap-spotting bem executado é suficiente e adequado. Em teses de doutorado e em linhas de pesquisa maduras, porém, vale perguntar se o estudo apenas preenche um detalhe marginal ou se enfrenta um problema estrutural do campo.
Medir a fragilidade da evidência
Nas ciências da saúde, a demonstração mais sólida de uma lacuna vem da avaliação sistemática da evidência existente. Aqui o pesquisador deixa de afirmar que a literatura é insuficiente e passa a mostrar onde e por que ela falha.
O framework de Robinson e colaboradores organiza essa demonstração em dois movimentos (Robinson et al., 2011). O primeiro é caracterizar a lacuna com os elementos do acrônimo PICOS: em que população, com que intervenção, contra que comparador, para que desfecho e em que cenário a evidência é deficiente. O segundo é classificar a causa da deficiência em uma de quatro categorias: informação insuficiente ou imprecisa, informação enviesada, inconsistência ou consistência desconhecida entre os estudos, e informação inadequada para a pergunta, como quando os estudos medem desfechos substitutos e não os desfechos que importam ao paciente. Os autores aplicaram o framework a cinquenta revisões sistemáticas e identificaram cerca de seiscentas lacunas distintas.
A classificação da causa tem valor estratégico, porque cada categoria pede um tipo diferente de estudo. Informação imprecisa pede estudos maiores. Informação enviesada pede desenhos mais rigorosos. Inconsistência pede investigação das fontes de heterogeneidade. Informação inadequada pede a mensuração dos desfechos corretos. A justificativa deixa de ser genérica e passa a indicar exatamente que estudo o campo precisa.
O sistema GRADE oferece o vocabulário mais difundido para graduar a certeza da evidência em quatro níveis, de alta a muito baixa, considerando cinco domínios que podem rebaixá-la: risco de viés, imprecisão, inconsistência, evidência indireta e viés de publicação. Uma revisão de escopo publicada em 2026 mapeou catorze frameworks destinados a identificar lacunas, formular necessidades e estabelecer prioridades a partir de sínteses de evidência; cinco caracterizavam as lacunas com PICO e seis investigavam explicitamente sua natureza, em geral por meio da avaliação de certeza do GRADE (Dewidar et al., 2026). A articulação entre os dois instrumentos é natural: o PICO diz onde está a lacuna, e o GRADE diz o tamanho da incerteza.
Uma ressalva é indispensável. Certeza baixa ou muito baixa significa que novos estudos provavelmente modificarão a estimativa de efeito, mas não transforma automaticamente a pergunta em prioridade. Uma questão pode ter evidência frágil e, ainda assim, pouca importância clínica. A mesma revisão observou que nenhum dos frameworks analisados incorporava integralmente os critérios do GRADE para a passagem da evidência à decisão, o que mostra que o salto entre incerteza e prioridade continua dependendo de juízo explícito (Dewidar et al., 2026).
Quando a pergunta é ampla ou o campo é heterogêneo demais para uma revisão sistemática, duas ferramentas de mapeamento ganham espaço. Os mapas de evidências e lacunas, difundidos pela International Initiative for Impact Evaluation e pela Campbell Collaboration, dispõem intervenções e desfechos em uma matriz e indicam, em cada célula, quantos estudos existem; as células vazias tornam a lacuna visível de relance. A revisão de Nyanchoka e colaboradores identificou catorze métodos distintos de exibição de lacunas e prioridades, o que dá dimensão da variedade dessas soluções gráficas (Nyanchoka et al., 2019). As revisões de escopo, conduzidas segundo o manual do Joanna Briggs Institute e relatadas conforme a extensão PRISMA-ScR, cumprem função semelhante em forma narrativa e tabular, com a vantagem de documentar a busca de modo reprodutível. Nenhuma das duas, contudo, avalia rotineiramente a certeza da evidência: elas mostram onde há estudos, não quanto se pode confiar neles.
Decompor a pergunta
Uma lacuna só pode ser demonstrada se a pergunta estiver bem delimitada. Perguntas vagas produzem buscas vagas, e buscas vagas não provam nada. Os acrônimos estruturais funcionam como moldura para decompor o problema em componentes que podem ser verificados um a um.
Antes da decomposição, convém um filtro de pertinência. Os critérios FINER, popularizados por Hulley e colaboradores no manual Designing Clinical Research, avaliam se a pergunta é exequível, interessante, nova, ética e relevante. O critério da novidade é justamente o que exige a demonstração da lacuna, mas os demais lembram que uma pergunta nova pode ser inviável ou irrelevante. Circulam na literatura extensões que acrescentam outros critérios, como a reprodutibilidade, mas sem padronização que permita tratá-las como versão oficial do acrônimo.
Para estudos de intervenção, o PICO e suas variantes são a referência. O acrônimo decompõe a pergunta em população, intervenção, comparador e desfecho; o PICOT acrescenta o horizonte temporal, e o PICOS, o desenho de estudo. A grande utilidade do PICO na justificativa é localizar a lacuna em um elemento específico. Talvez a intervenção já tenha sido estudada, mas nunca contra o comparador usado na prática brasileira. Talvez os desfechos medidos sejam laboratoriais e falte o desfecho funcional. Talvez o seguimento seja curto demais. Cada uma dessas situações configura uma lacuna diferente, e o PICO permite nomeá-la.
Para revisões de escopo, o Joanna Briggs Institute recomenda o acrônimo PCC, que trabalha com população, conceito e contexto. A estrutura evita o afunilamento excessivo do PICO e é adequada quando o objetivo é mapear um campo, e não estimar um efeito. Para estudos de prevalência e incidência, o mesmo instituto propõe o CoCoPop, que articula condição, contexto e população e ajuda a identificar regiões ou estratos sem dados epidemiológicos.
Outras molduras atendem a perguntas que não cabem no modelo clínico intervencionista. O SPICE, que considera cenário, perspectiva, intervenção, comparação e avaliação, foi pensado para serviços de saúde e de informação, em que a perspectiva do usuário pesa mais do que a fisiopatologia. O ECLIPSE, que articula expectativa, grupo de clientes, local, impacto, profissionais e serviço, volta-se à gestão de serviços. O SPIDER, que trabalha com amostra, fenômeno de interesse, desenho, avaliação e tipo de pesquisa, foi adaptado para estudos qualitativos e de métodos mistos. O PEO, com população, exposição e desfecho, atende a estudos observacionais sobre fatores de risco.
A escolha da moldura não é questão de preferência estética. Ela decorre do tipo de pergunta, e uma moldura inadequada distorce a busca e, por consequência, a demonstração da lacuna. Um estudo qualitativo sobre a experiência de cuidadores, estruturado à força em PICO, produzirá uma estratégia de busca que perde exatamente os estudos que deveria encontrar.
Ouvir quem decide e quem vive o problema
Há lacunas que a literatura não revela sozinha. A revisão sistemática mostra que a evidência é insuficiente, mas não diz quais incertezas mais importam a quem usa o sistema de saúde. Para isso existem os métodos participativos, que recorrem ao julgamento estruturado de especialistas, profissionais e pacientes. A revisão de Nyanchoka e colaboradores identificou, entre os métodos usados para determinar prioridades de pesquisa, o inquérito Delphi, os inquéritos quantitativos, a síntese de conhecimento, os exercícios formais de estabelecimento de prioridades e o mapeamento global de evidências (Nyanchoka et al., 2019).
A metodologia da James Lind Alliance, desenvolvida no Reino Unido, organiza parcerias de priorização em que pacientes, cuidadores e profissionais participam em condições de igualdade. O processo coleta incertezas sobre tratamento, verifica se elas já foram respondidas pela literatura e, por meio de etapas sucessivas de votação e de uma oficina final, produz uma lista ordenada com as dez prioridades principais. A contribuição distintiva é a voz do paciente: incertezas que os pesquisadores não consideravam relevantes frequentemente sobem para o topo da lista.
A técnica Delphi submete um painel de especialistas a rodadas sucessivas de questionários anônimos, com devolutiva estruturada das respostas do grupo entre uma rodada e outra, até que se atinja o limiar de consenso definido no protocolo. O anonimato reduz a influência de lideranças dominantes e de hierarquias institucionais. A Técnica de Grupo Nominal segue lógica semelhante em formato presencial ou virtual síncrono: os participantes geram ideias em silêncio, apresentam-nas em rodízio, discutem-nas e votam individualmente, o que produz uma lista ponderada em pouco tempo.
O método de adequação da RAND e da Universidade da Califórnia em Los Angeles combina revisão da literatura com painéis multidisciplinares que pontuam a adequação de intervenções em cenários clínicos específicos. As indicações são classificadas como apropriadas, inapropriadas ou incertas, e a categoria de incerteza funciona como sinal direto de que faltam estudos para aquele subgrupo de pacientes.
Esses métodos têm um limite que precisa ser reconhecido: consenso não é evidência. Eles identificam o que um grupo considera incerto e prioritário, e o resultado depende de quem foi convidado para o painel. Por isso funcionam melhor quando combinados com a avaliação sistemática da literatura, que verifica se a incerteza apontada é real ou apenas desconhecimento do que já foi publicado.
Ler a literatura em escala
A quinta família de métodos responde a um problema de volume. Em campos com dezenas de milhares de publicações, nenhuma leitura manual dá conta do panorama, e as técnicas computacionais oferecem uma visão de conjunto.
A cienciometria analisa metadados de bases como Web of Science, Scopus e PubMed para desenhar redes de coocorrência de termos, de cocitação e de colaboração. Programas como o VOSviewer, o pacote Bibliometrix para a linguagem R e o CiteSpace transformam esses metadados em mapas em que aglomerados densos indicam os temas centrais do campo e regiões esparsas sugerem temas periféricos ou pouco explorados. A revisão de Nyanchoka e colaboradores incluiu os estudos bibliométricos entre os métodos usados para identificar lacunas em saúde (Nyanchoka et al., 2019).
A modelagem de tópicos vai além dos metadados e trabalha com o texto de títulos e resumos. Algoritmos de aprendizagem não supervisionada, como a alocação latente de Dirichlet, e abordagens mais recentes baseadas em representações vetoriais de linguagem agrupam documentos por afinidade temática e permitem acompanhar a trajetória de cada tema ao longo do tempo: os que crescem, os que estagnam e os que surgem.
A análise historiográfica de citações reconstrói a genealogia de um conceito, da publicação seminal às derivações contemporâneas. Ferramentas como o CitNetExplorer permitem identificar linhas de investigação abandonadas sem resolução, o que pode sinalizar lacunas antigas que novas tecnologias tornaram tratáveis.
Esses métodos exigem uma cautela fundamental: um vazio no mapa não prova uma lacuna na ciência. Ele reflete a cobertura da base consultada, os termos de indexação e as escolhas do analista. Para o pesquisador brasileiro, a advertência é concreta, porque parte relevante da produção latino-americana está indexada na LILACS e na SciELO e pode não aparecer em mapas construídos apenas com a Web of Science ou a Scopus. O vazio bibliométrico é uma hipótese a ser verificada, não uma conclusão.
A IA generativa como assistente, não como oráculo
A inteligência artificial generativa chegou ao cotidiano do pesquisador como promessa de atalho para todas as etapas descritas até aqui. A promessa é parcialmente verdadeira. Os modelos de linguagem podem acelerar muito do trabalho preparatório, mas há uma tarefa que eles não podem cumprir: provar que algo não existe.
Começando pelo que funciona bem. Na decomposição da pergunta, o modelo pode converter uma ideia clínica ainda difusa em estruturas PICO, PCC ou SPIDER alternativas, permitindo comparar recortes, e pode testar a pergunta contra os critérios FINER, apontando fragilidades de viabilidade ou de relevância. Na construção da estratégia de busca, pode ampliar o vocabulário com sinônimos, variantes de grafia e termos em inglês, além de sugerir candidatos a descritores, que precisam ser conferidos no DeCS e no MeSH, já que o modelo pode propor termos inexistentes ou desatualizados.
Na etapa de nomeação, o modelo pode propor a classificação da lacuna segundo as taxonomias de Müller-Bloch e Kranz ou de Miles, desde que receba como insumo os trechos de discussão e de limitações dos estudos que o próprio pesquisador localizou e leu. Na problematização, pode funcionar como interlocutor crítico, explicitando pressupostos de uma linha de pesquisa e formulando objeções, à maneira do exercício proposto por Sandberg e Alvesson. Na triagem de títulos e resumos e na extração estruturada das seções de recomendação de pesquisa futura, pode reduzir o trabalho mecânico, sob dupla checagem humana. Nos métodos participativos, pode ajudar a redigir itens de questionários Delphi e a sintetizar comentários abertos entre as rodadas. Na leitura em escala, pode sugerir rótulos para agrupamentos gerados por modelagem de tópicos ou por mapas bibliométricos.
O limite, por sua vez, é estrutural. O modelo não tem acesso exaustivo e auditável às bases bibliográficas e produz texto plausível mesmo quando não dispõe de informação. Um estudo comparativo pediu a três modelos que reproduzissem as buscas de onze revisões sistemáticas e encontrou taxas de alucinação de referências de 39,6% para o GPT-3.5, 28,6% para o GPT-4 e 91,4% para o Bard, com precisão que não passou de 13,4%. Os autores, Chelli e colaboradores, publicaram o trabalho em 2024 no Journal of Medical Internet Research e concluíram que esses modelos não devem ser a ferramenta principal ou exclusiva de uma revisão sistemática, e que toda referência gerada exige validação. É preciso registrar que o estudo avaliou modelos disponíveis em 2023 e que o desempenho de sistemas mais recentes, sobretudo os que consultam a internet em tempo real, pode ser diferente. A conclusão metodológica, porém, permanece: a resposta de um modelo de linguagem não substitui uma busca documentada em bases bibliográficas.
O segundo limite diz respeito ao julgamento. A atribuição de certeza pelo GRADE, a decisão sobre o que é prioritário e a escolha entre preencher e problematizar envolvem juízos metodológicos e de valor que não se delegam. A declaração conjunta publicada em 2025 pela Cochrane, pela Campbell Collaboration, pelo Joanna Briggs Institute e pela Collaboration for Environmental Evidence, baseada nas recomendações RAISE para o uso responsável de inteligência artificial em síntese de evidências, fixa três princípios (Flemyng et al., 2025). O autor permanece responsável pela síntese, inclusive pela decisão de usar inteligência artificial e pelo impacto desse uso. O uso deve ocorrer com supervisão humana. E qualquer emprego que produza ou sugira julgamentos deve ser relatado de forma completa e transparente, com identificação da ferramenta, da versão, da finalidade e das etapas afetadas.
A regra prática que resulta desse quadro pode ser enunciada em uma frase: a inteligência artificial sugere, as bases provam e o pesquisador julga. Há ainda um cuidado adicional, frequentemente esquecido: dados não publicados, protocolos em elaboração e informações de participantes não devem ser inseridos em ferramentas cujas condições de uso não garantam confidencialidade compatível com a legislação de proteção de dados e com as exigências do sistema de ética em pesquisa.
Um roteiro integrado
As cinco famílias de métodos e a inteligência artificial não competem entre si. Cada uma responde a uma exigência diferente e entra em um momento distinto do projeto. Um roteiro possível, adaptável ao tipo de pergunta, tem quatro movimentos.
O primeiro é explorar. Com a pergunta ainda aberta, o pesquisador usa o PCC ou o PICO para delimitá-la, a inteligência artificial para ampliar o vocabulário de busca e, em campos volumosos, um mapeamento bibliométrico preliminar para conhecer o terreno. O resultado é uma estratégia de busca documentada, executada em bases adequadas ao tema, incluindo as regionais.
O segundo é nomear. Com os estudos relevantes em mãos, a lacuna é classificada segundo uma taxonomia e confrontada com a pergunta: se trata de vazio de conhecimento, de evidência contraditória, de problema metodológico ou de população negligenciada. Nesse ponto cabe também perguntar se o projeto apenas preenche uma lacuna ou se problematiza um pressuposto.
O terceiro é medir. A lacuna é caracterizada com PICOS e sua causa é classificada segundo o framework de Robinson; quando houver síntese de evidências disponível, a certeza é graduada pelo GRADE. É aqui que a declaração se converte em demonstração.
O quarto é priorizar, quando o projeto tiver alcance institucional ou de política pública. Métodos participativos verificam se a incerteza demonstrada importa a quem usa o sistema de saúde. A revisão de 2026 mostrou que os frameworks disponíveis são heterogêneos e raramente oferecem métodos explícitos de priorização (Dewidar et al., 2026), de modo que o pesquisador precisa declarar como decidiu.
Ao final, a justificativa pode ser escrita em uma frase de estrutura previsível: em determinada população, para determinada intervenção ou fenômeno, a evidência é insuficiente, enviesada, inconsistente ou inadequada, conforme demonstrado por determinado método, o que caracteriza uma lacuna de determinado tipo. Uma frase assim resiste a qualquer banca, porque cada um de seus termos pode ser verificado.
Considerações finais
A afirmação de que não há nada publicado sobre um tema é, quase sempre, uma confissão involuntária de que a busca foi insuficiente. A lacuna científica legítima tem três atributos verificáveis: um nome, que a classifica; uma causa, que explica por que a evidência falha; e uma prova, que documenta essa falha de modo reprodutível. As taxonomias, os instrumentos de avaliação da evidência, os acrônimos estruturais, os métodos participativos e as técnicas computacionais oferecem, juntos, os meios para cumprir essas três exigências, e a inteligência artificial generativa pode tornar o percurso mais rápido sem torná-lo menos rigoroso, desde que usada como assistente e não como oráculo.
Há, contudo, uma lição que ultrapassa a técnica. Demonstrar uma lacuna é um exercício de honestidade intelectual: obriga o pesquisador a conhecer o que já foi feito, a reconhecer o mérito do trabalho alheio e a admitir os limites do próprio conhecimento. O cartógrafo antigo que deixava em branco a terra desconhecida não estava sendo negligente, estava sendo preciso. Antes de prometer explorar o território, vale perguntar com franqueza: eu sei mesmo onde termina o mapa?
Fontes
[1]. Robinson KA, Saldanha IJ, McKoy NA. Development of a framework to identify research gaps from systematic reviews. J Clin Epidemiol. 2011;64(12):1325-30.
DOI: https://doi.org/10.1016/j.jclinepi.2011.06.009
Disponível em: https://www.sciencedirect.com/science/article/abs/pii/S0895435611002046
Comentário: artigo seminal da síntese de evidências em saúde sobre a identificação explícita de lacunas. Propõe caracterizar a lacuna pelos elementos do PICOS e classificar sua causa em quatro categorias, da imprecisão à inadequação da informação. Fundamenta a distinção entre ausência e insuficiência de evidência, central neste texto, e oferece o instrumento mais diretamente aplicável à redação de justificativas em projetos clínicos.
[2]. Sandberg J, Alvesson M. Ways of constructing research questions: gap-spotting or problematization? Organization. 2011;18(1):23-44.
DOI: https://doi.org/10.1177/1350508410372151
Disponível em: https://lusem.lu.se/mats-alvesson/publication/b3784fb2-62b8-4e2a-af84-e18c9cb079b3
Comentário: a partir da análise de 52 artigos de estudos organizacionais, os autores descrevem os modos dominantes de construção de perguntas de pesquisa e mostram que a busca por lacunas tende a reforçar, e não a desafiar, as teorias vigentes. Sustenta a seção sobre preencher ou problematizar e convida o leitor a avaliar a relevância estrutural de sua pergunta, não apenas sua novidade.
[3]. Nyanchoka L, Tudur-Smith C, Thu VN, Iversen V, Tricco AC, Porcher R. A scoping review describes methods used to identify, prioritize and display gaps in health research. J Clin Epidemiol. 2019;109:99-110.
DOI: https://doi.org/10.1016/j.jclinepi.2019.01.005
Disponível em: https://ntnuopen.ntnu.no/ntnu-xmlui/handle/11250/2739811
Comentário: revisão de escopo com 139 publicações que mapeia definições de lacuna e métodos para identificá-las, priorizá-las e exibi-las em pesquisa em saúde. Documenta a heterogeneidade conceitual do campo e reúne, em um único estudo, os métodos participativos, bibliométricos e de exibição gráfica discutidos aqui. É uma porta de entrada útil para quem deseja aprofundar qualquer uma das famílias de métodos.
[4]. Dewidar O, Elganga M, Ringsten M, Langendam M, Saif-Ur-Rahman KM, Bala MM, et al. Frameworks to identify research gaps, frame research needs, and derive research priorities from evidence syntheses: a scoping review. J Clin Epidemiol. 2026;197:112342.
DOI: https://doi.org/10.1016/j.jclinepi.2026.112342
Disponível em: https://lup.lub.lu.se/record/dd6d64fd-fb3e-48ac-b068-94d5363711e7
Comentário: revisão de escopo recente, conduzida por grupo ligado ao GRADE, que identificou catorze frameworks para passar das lacunas às necessidades e às prioridades de pesquisa. Mostra a combinação frequente entre PICO e avaliação de certeza da evidência e evidencia a escassez de métodos explícitos de priorização. Atualiza o estado da arte e justifica a recomendação de que o pesquisador declare como decidiu o que é prioritário.
[5]. Flemyng E, Noel-Storr A, Macura B, Gartlehner G, Thomas J, Meerpohl JJ, et al. Position statement on artificial intelligence (AI) use in evidence synthesis across Cochrane, the Campbell Collaboration, JBI and the Collaboration for Environmental Evidence 2025. JBI Evid Synth. 2025;23(11):2162-6.
DOI: https://doi.org/10.11124/JBIES-25-00480
Disponível em: https://pmc.ncbi.nlm.nih.gov/articles/PMC12594113/
Comentário: declaração conjunta das principais organizações internacionais de síntese de evidências, publicada simultaneamente em vários periódicos, que adota as recomendações RAISE para o uso responsável de inteligência artificial. Estabelece a responsabilidade do autor, a necessidade de supervisão humana e o dever de relato transparente. Fornece o marco normativo da seção sobre inteligência artificial generativa.
Pontos para Recordar
- Afirmar que não há nada publicado sobre um tema é uma afirmação empírica que exige busca documentada e reprodutível em bases bibliográficas adequadas.
- Uma lacuna de pesquisa corresponde à evidência insuficiente para responder a uma pergunta, o que inclui estudos pequenos, enviesados, contraditórios ou inadequados, e não apenas a ausência de estudos.
- Taxonomias como as de Müller-Bloch e Kranz e de Miles permitem nomear a lacuna como contraditória, metodológica, empírica, teórica ou populacional, entre outros tipos.
- O framework de Robinson caracteriza a lacuna pelos elementos do PICOS e classifica sua causa em imprecisão, viés, inconsistência ou inadequação da informação, o que indica o tipo de estudo necessário.
- Certeza baixa da evidência segundo o GRADE indica incerteza, mas não torna a pergunta automaticamente prioritária, porque prioridade exige juízo sobre relevância e viabilidade.
- Métodos participativos e mapas bibliométricos revelam incertezas e vazios aparentes, mas consenso não é evidência e vazio no mapa não é prova de lacuna.
- A inteligência artificial generativa pode acelerar a delimitação da pergunta, a busca e a triagem, mas não pode provar a inexistência de estudos, e seu uso exige supervisão humana e relato transparente.
Declaração de uso de Inteligência Artificial Generativa
Este texto foi produzido com o auxílio de Claude Opus 5.5, desenvolvida pela Anthropic, utilizado como ferramenta de apoio nas fases de brainstorming, de estruturação do conteúdo e de produção do texto. A imagem foi produzida com auxílio do Claude Opus 5.5, da Anthropic. A responsabilidade pela versão final e precisão das informações, pelo pensamento crítico, pela seleção das fontes e pelo conteúdo publicado é integralmente do autor.
Declaração de uso da inteligência humana
Declaro que a elaboração deste trabalho contou com o uso de inteligência humana desde a ideação, passando pela formulação das perguntas, pela escolha dos argumentos, pela interpretação das informações e pelas decisões sobre o que comunicar. Essa inteligência gerenciou o uso dos recursos tecnológicos, incluindo computadores, internet, processadores eletrônicos de texto, corretores ortográficos, planilhas de dados e aplicativos de criação de desenhos e imagens. Também orquestrou o uso de recursos de inteligência artificial generativa, definindo suas finalidades, orientando as solicitações, avaliando as respostas e decidindo o que incorporar, modificar ou descartar. Seu uso envolveu curiosidade, memória, experiência, dúvida e julgamento crítico. Reconheço que essa inteligência está sujeita a vieses, cansaço, lacunas de conhecimento e erros, inclusive quando se expressa com segurança. As ferramentas utilizadas apoiaram o processo de criação. A responsabilidade pelo conteúdo que escolhi publicar, por suas implicações e pelas correções necessárias permanece minha. Declaro, por fim, que o exercício da inteligência humana inclui reconhecer o que não sei, verificar o que afirmo e rever o que penso diante de boas razões. Aliás, a responsabilidade humana pelo que se publica sempre foi essa, mesmo antes da IA generativa. Este texto contou com participação humana consciente, falível e responsável.